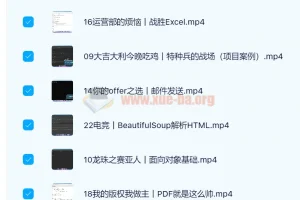
本课程是一套系统完整的Python分布式爬虫实战教学,源自慕课网广受好评的畅销课程,专为希望深入掌握爬虫技术的开发者打造。课程内容从环境搭建起步,循序渐进地覆盖爬虫基础知识、Scrapy框架核心应用、反爬突破策略、分布式爬虫实现,直至最终完成一个基于Elasticsearch和Django的搜索引擎网站,形成完整的技术闭环。 课程以真实项目驱动教学,包含多个高价值实战案例:爬取知名技术文章网站、模拟登录知乎并抓取问答数据、整站爬取招聘网站职位信息等。每个案例都深入剖析实现细节,例如如何设计cookie池系统应对登录限制、如何通过云打码与滑动验证码识别突破验证机制、如何利用scrapy-redi…...
本课程专为Python初学者与中级开发者量身打造,通过8天高强度实战训练,系统掌握网站数据抓取核心技能。课程内容由浅入深,覆盖爬虫技术全链路,包括网页结构解析、数据清洗与提取、请求模拟、反爬虫策略识别与绕过等关键知识点。
课程摒弃枯燥理论,全程以真实网站为案例,从静态页面抓取到动态渲染数据采集,从表单登录到验证码处理,每一步都配有可运行的完整代码与详细讲解。学员将亲手完成多个实战项目,例如电商商品信息采集、新闻资讯聚合、社交媒体数据分析等,真正实现“学完即用”。
无论你是想提升职场竞争力的开发者,还是对数据采集感兴趣的编程爱好者,这套课程都能帮助你快速建立爬虫思维,掌握高效获取网络公开数据的实用方法。8天集中学习,助你从零基础成长为能独立应对常见反爬场景的爬虫工程师。
📢 以下文件由夸克网盘用户于2024-12-23分享(文件数量过多时仅展示部分文件)
全部文件11.23GB
《Python超强爬虫》8天速成爬取各种网站数据实战案例.7z11.23GB
共1个文件,合计:11.23GB

10积分