介绍
零基础:21天搞定Python分布爬虫 – 带源码课件,资源。
在IT领域,Python爬虫是一项重要的技能,尤其对于数据挖掘和数据分析从业者来说更是不可或缺。
《零基础:21天搞定Python分布爬虫》这个课程针对初学者,旨在通过21天的学习,帮助大家掌握Python爬虫的基础知识以及分布式爬虫的实现。
本课程内容体系完整,从最基础的爬虫概念讲起,逐步深入到分布式爬虫架构,全程配合实战案例,让学习者能够真正掌握爬虫技术的核心要点。课程共分为六大章节,循序渐进地构建起完整的爬虫知识体系:
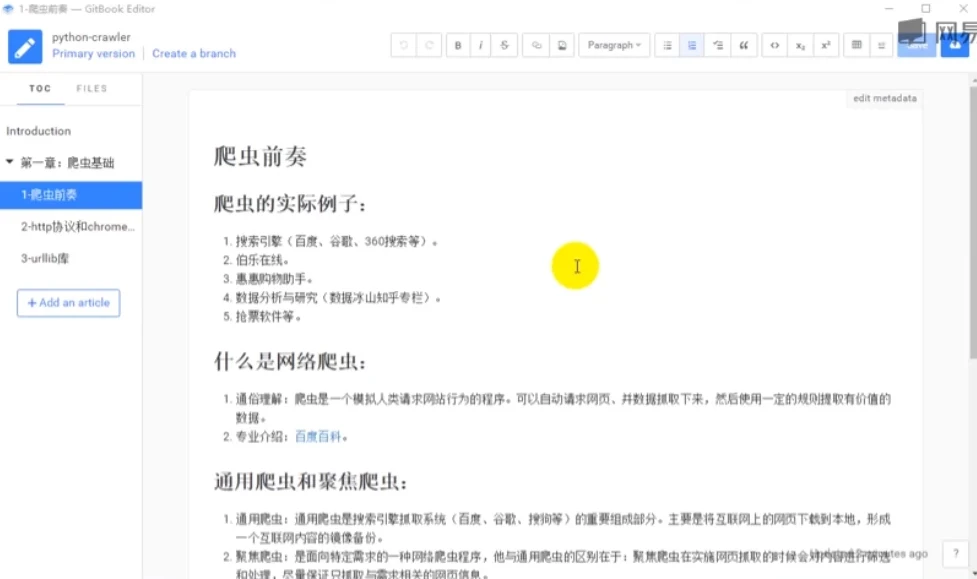
章节1:爬虫前奏——从零开始认识网络爬虫,理解HTTP协议原理,掌握抓包工具的使用方法,为后续学习打下坚实基础。
章节2:网络请求——系统讲解urllib与requests两大请求库的核心用法,涵盖URL编码解码、代理IP设置、cookie处理、SSL证书等关键知识点。通过拉勾网职位信息爬取实战,让学习者快速上手真实场景下的数据采集。
章节3:数据解析——深入讲解三种主流解析方式:XPath与lxml、BeautifulSoup(bs4)、正则表达式。每个知识点都配有实战案例,包括豆瓣电影、电影天堂、中国天气网、古诗文网等热门网站的完整爬取流程,帮助学习者掌握不同场景下的数据提取技巧。
章节4:数据储存——全面覆盖JSON、CSV、MySQL、MongoDB四种数据存储方案,从基础语法到数据库连接操作,再到增删改查的完整实现,让爬取到的数据能够被有效管理和利用。
章节5:爬虫进阶——重点攻克爬虫技术中的难点:多线程与异步爬虫提升采集效率,selenium模拟浏览器操作应对动态页面,tesseract识别验证码突破登录限制。特别包含12306抢票脚本的完整实现,极具实战价值。
章节6:Scrapy框架——系统学习Scrapy爬虫框架的架构设计与核心组件,掌握CrawlSpider、中间件、分布式爬虫等高级特性。通过糗事百科、豆瓣网、BOSS直聘、简书网、房天下等大型实战项目,深入理解反爬虫对抗策略与分布式爬虫的部署实现。
课程附带完整的源码与课件资料,每个章节的实战案例均有配套代码,方便学习者对照练习与二次开发。无论是准备进入数据采集领域的初学者,还是希望系统提升爬虫技能的开发者,这套课程都能提供清晰的学习路径与丰富的实战经验。
 夸克网盘
 10积分