本课程是一套面向零基础学员的深度学习与PyTorch实战教程,内容覆盖从神经网络基础理论到PyTorch框架应用的全流程。课程以通俗易懂的方式拆解复杂概念,配合大量可操作的实战案例,帮助学习者真正掌握AI模型构建、训练与优化的核心技能。
课程内容分为多个递进模块,首先从神经网络的基本任务、模型更新方法、损失函数计算、前向传播与反向传播等核心概念入手,配合可视化分析帮助理解神经元个数、预处理与dropout的实际作用。随后深入卷积神经网络(CNN),详细讲解卷积计算流程、层次结构、参数共享、池化层作用以及经典网络架构,为图像识别等任务打下坚实基础。
在序列建模部分,课程系统讲解了RNN网络结构原理、注意力机制的历史演变、self-attention的核心思想、QKV的来源与作用、多头注意力机制、位置编码与解码器,以及BERT的训练方式,帮助学习者掌握现代NLP模型的底层逻辑。PyTorch框架部分则从与其他框架的对比、CPU与GPU版本安装方法开始,逐步演示基本模块应用、网络结构定义、数据源定义、损失与训练模块配置,最终完成分类模型的训练与参数调优。
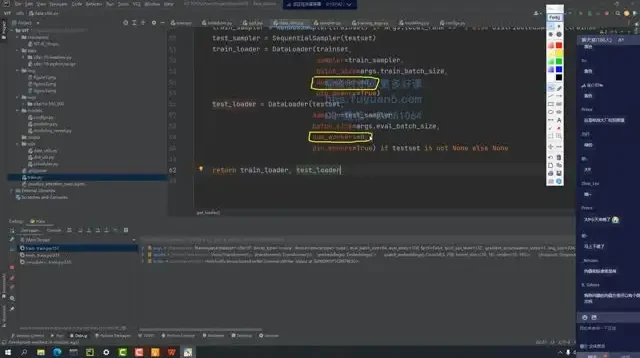
实战环节覆盖多个典型应用场景:包括图像分类任务中的参数初始化、卷积网络模型训练与预测;图像数据增强、迁移学习、输出层与梯度设置、优化器与学习率衰减等进阶技巧;以及基于Dataloader的数据加载与模型训练流程。自然语言处理部分则包含文本数据处理、命令行参数调试、字符预处理转换、LSTM网络定义与模型预测输出,并最终通过Flask搭建服务端完成模型部署与测试。课程最后还安排了视觉Transformer(ViT)项目实战,从源码准备、Embedding模块实现、分块任务、QKV计算到特征加权分配与损失计算训练,完整呈现前沿模型的实现细节。
整套课程以项目驱动为导向,每个章节都配有清晰的讲解与演示,适合希望快速入门AI领域并应用于实际工作的学习者。无论是学生、转行人员还是在职开发者,都能通过本课程建立起系统的深度学习知识体系,并具备独立完成AI项目的能力。
 夸克网盘
 10积分